MicroCloud: nuvem privada com alta disponibilidade em minutos
Montar uma nuvem privada costumava significar semanas de projeto: um cluster de virtualização, um storage distribuído, uma rede definida por software e muita configuração para fazer tudo conversar. O MicroCloud, da Canonical, empresa por trás do Ubuntu, resolve isso de outro jeito. Você instala alguns pacotes, roda um comando e, em poucos minutos, tem um cluster com computação, armazenamento replicado e rede prontos para uso.
Neste artigo explicamos o que é o MicroCloud, como ele funciona, o que ele exige e o que acontece de verdade quando um servidor cai. Montamos um laboratório com três nós, derrubamos um deles de propósito e medimos o resultado.
O que é o MicroCloud
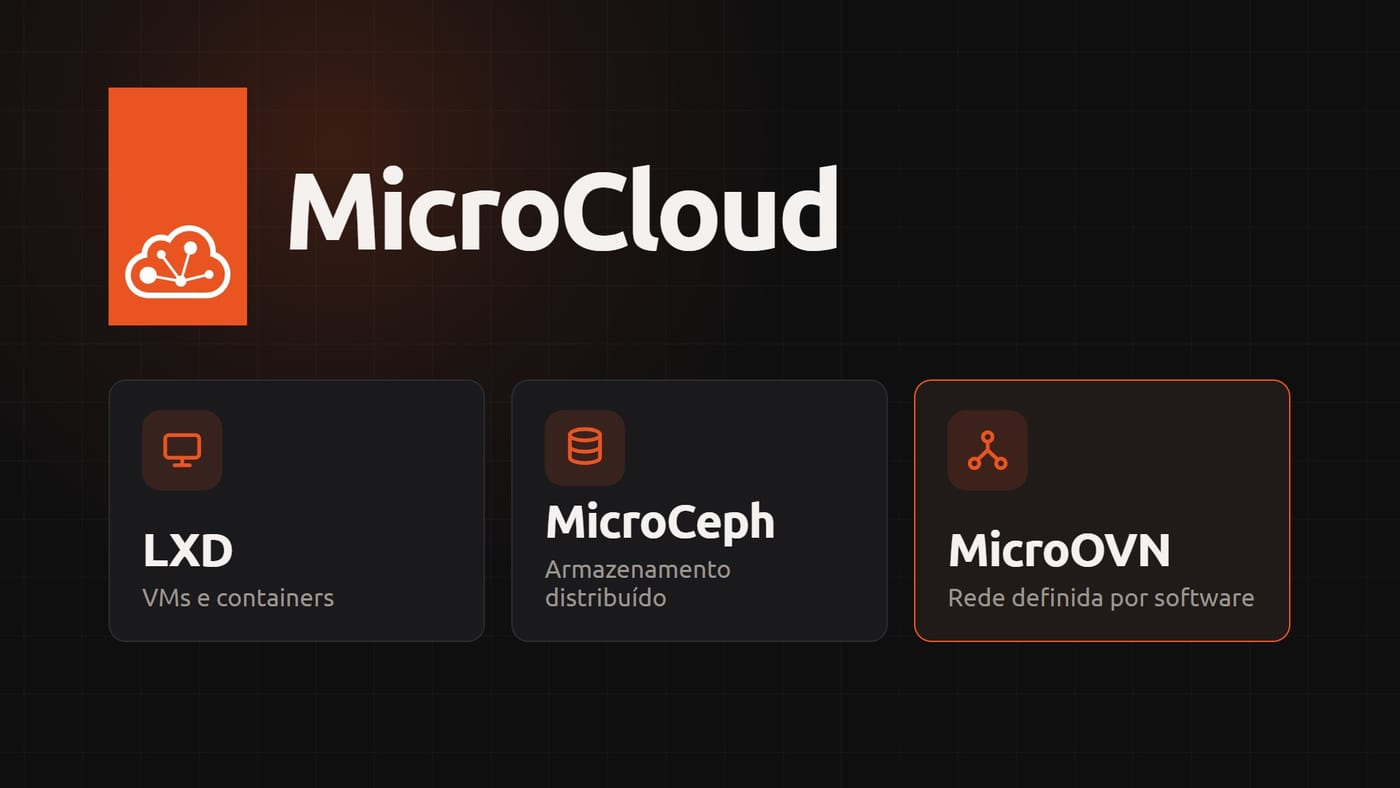
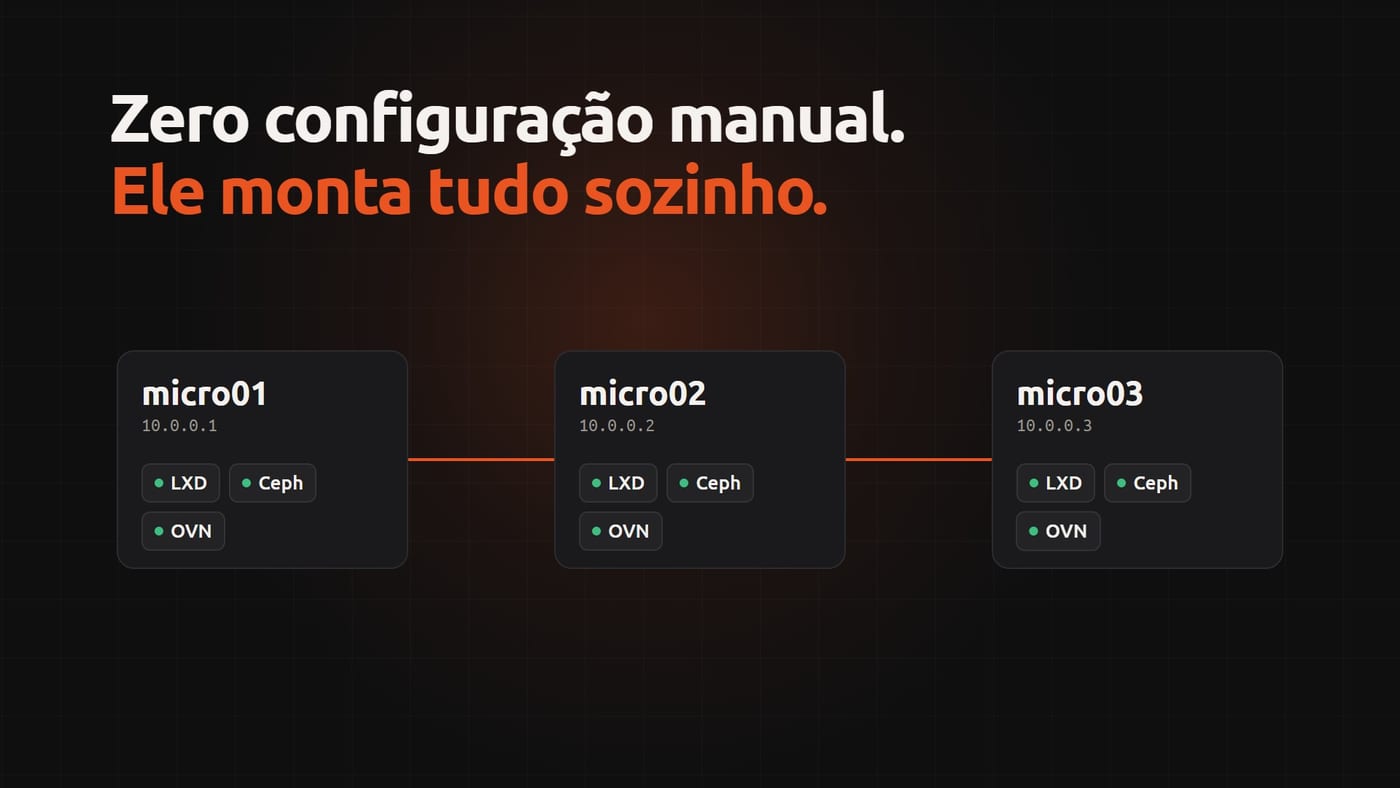
O MicroCloud é um orquestrador. Ele não reinventa nenhuma peça: pega três projetos maduros e open source, instala um em cada servidor e configura todos para trabalharem como um conjunto.
| Componente | Função | O que entrega |
|---|---|---|
| LXD | Computação | Máquinas virtuais e containers de sistema, com interface web e API |
| MicroCeph | Armazenamento | Ceph distribuído, com os dados replicados em três servidores |
| MicroOVN | Rede | Rede virtual entre os servidores, com roteamento e NAT para a rede da empresa |
Cada peça vem como um snap, o que mantém as versões iguais em todos os servidores e facilita as atualizações. Ao final da instalação, você tem três clusters (LXD, Ceph e OVN) já integrados entre si: o LXD sabe gravar os discos no Ceph e ligar as instâncias na rede do OVN.
Como a instalação funciona
O roteiro é curto. Em cada servidor, com Ubuntu 22.04 ou 24.04 LTS, você instala os quatro snaps:
sudo snap install lxd        --channel=6/stable     --cohort="+"
sudo snap install microceph  --channel=squid/stable --cohort="+"
sudo snap install microovn   --channel=24.03/stable --cohort="+"
sudo snap install microcloud --channel=3/stable     --cohort="+"
sudo snap refresh --hold lxd microceph microovn microcloud
O --cohort garante que todos os nós fiquem exatamente na mesma versão. O --hold impede que um servidor se atualize sozinho e fique diferente dos outros, porque em cluster a atualização deve ser planejada.
Depois, em um dos servidores, você roda microcloud init; nos demais, microcloud join. Os servidores se encontram sozinhos na rede local por multicast, trocam uma senha de sessão e o MicroCloud pergunta só o essencial: quais discos usar para armazenamento local, quais vão para o Ceph, qual placa de rede será o uplink e qual faixa de IPs a rede virtual pode usar.
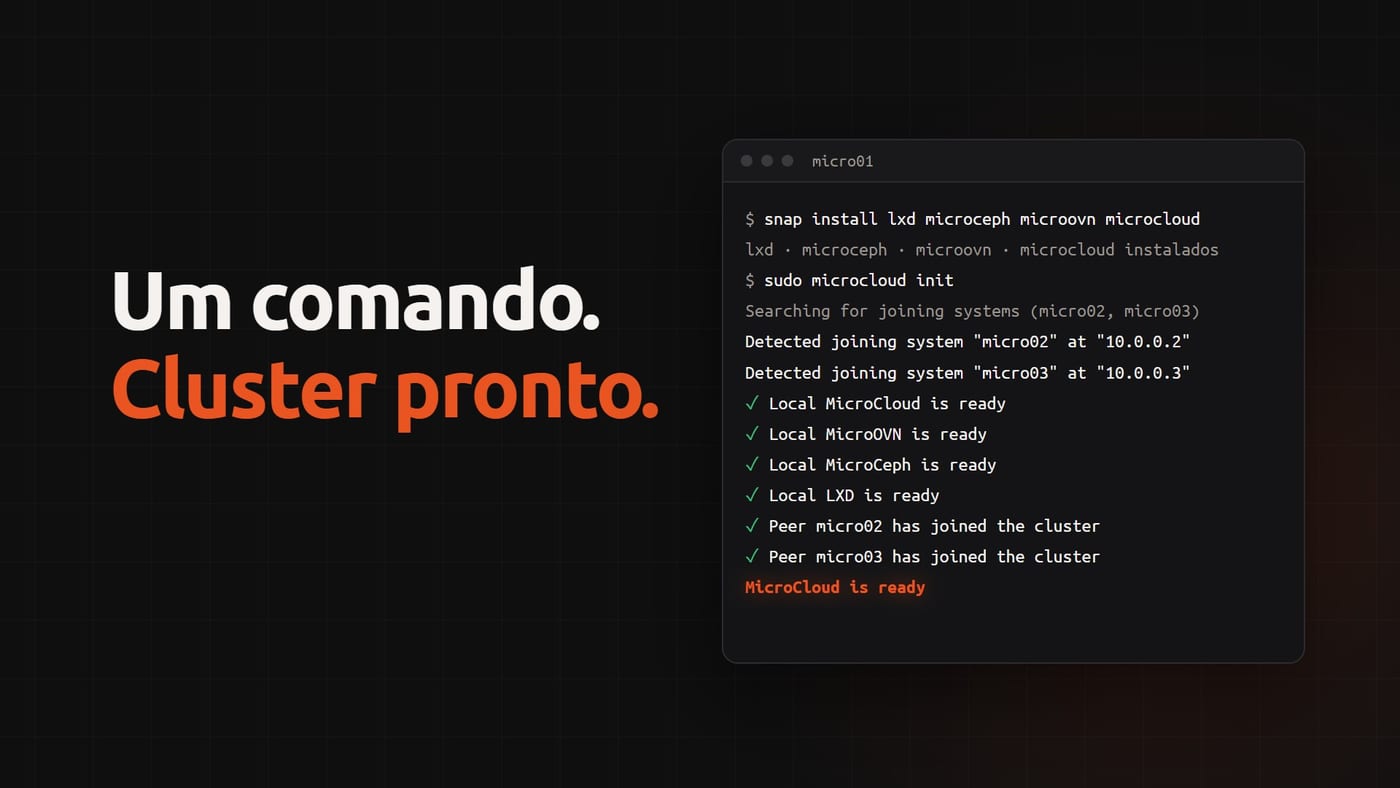
microcloud preseed, sem nenhuma pergunta interativa. É o caminho ideal para padronizar filiais ou laboratórios.O que ele exige
O MicroCloud funciona em um único servidor para teste, mas alta disponibilidade de verdade começa em três. Os requisitos da documentação oficial, resumidos:
| Item | Teste e laboratório | Produção |
|---|---|---|
| Servidores | 1 (ou 3 para testar HA); físicos ou virtuais | Mínimo 3 físicos; 4 ou mais para cargas críticas |
| Memória | 8 GB por servidor | 32 GB por servidor |
| Discos | 1 para o sistema + 1 local + 1 para o Ceph | 3 NVMe por servidor: sistema, local e Ceph |
| Rede | 2 interfaces por servidor | Placas de 10 Gb, de preferência com duas portas |
| Tamanho máximo | Até 50 servidores no mesmo cluster | |
As duas interfaces de rede têm papéis diferentes. A primeira tem IP fixo (DHCP não é suportado) e carrega o tráfego interno do cluster: Ceph, banco de dados do LXD e controle do OVN. A segunda fica sem IP e é entregue ao OVN como uplink, a porta por onde as instâncias saem para a rede da empresa.
Armazenamento: local ou distribuído
Cada instância pode ter o disco em um de dois lugares:
- Local (ZFS): mais rápido, mas o disco fica preso ao servidor. Se o servidor parar, a instância para junto.
- Distribuído (Ceph): o disco existe em três servidores ao mesmo tempo. É isso que permite mover instâncias entre servidores e religá-las em outro lugar quando um nó cai.
A conta de capacidade do Ceph pega muita gente de surpresa: com três réplicas, o espaço útil é cerca de um terço do espaço bruto. Três discos de 100 GB entregam algo perto de 94 GiB utilizáveis, e não 300. Dimensione pensando nisso. E lembre que replicação protege contra falha de hardware, não contra exclusão acidental ou ransomware: o backup 3-2-1 continua obrigatório.
Alta disponibilidade na prática
Documentação é uma coisa; derrubar um servidor é outra. No nosso laboratório, montamos três nós com Ceph replicado e rodamos dois testes com uma VM Windows Server 2022, medindo com ping contínuo a partir de outra instância.
Teste 1: live migration
Movemos a VM Windows de um servidor para outro com ela ligada. A migração levou 34 segundos (o tempo de copiar a memória da VM) e, durante todo esse tempo, a VM continuou respondendo. Foram perdidos 2 pings de 219, cerca de 0,4 segundo sem resposta no instante da troca. O Windows não reiniciou e nenhum usuário perceberia.
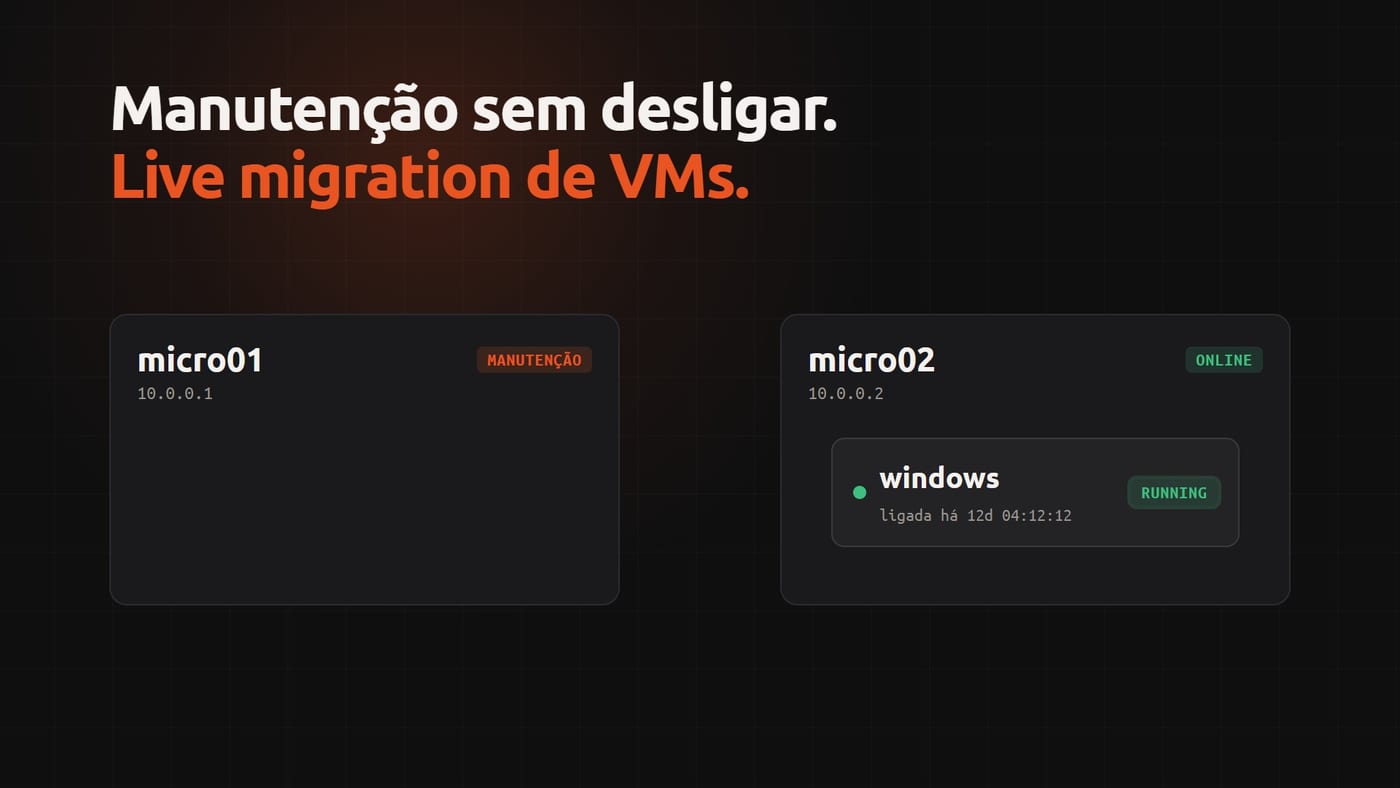
É o recurso que torna a manutenção tranquila: antes de atualizar ou trocar uma peça de um servidor, você move as VMs para os outros e trabalha sem janela de parada.
migration.stateful=true. Containers precisam ser parados para mudar de servidor. Com o disco no Ceph, isso leva poucos segundos, mas é uma parada.Teste 2: um servidor cai
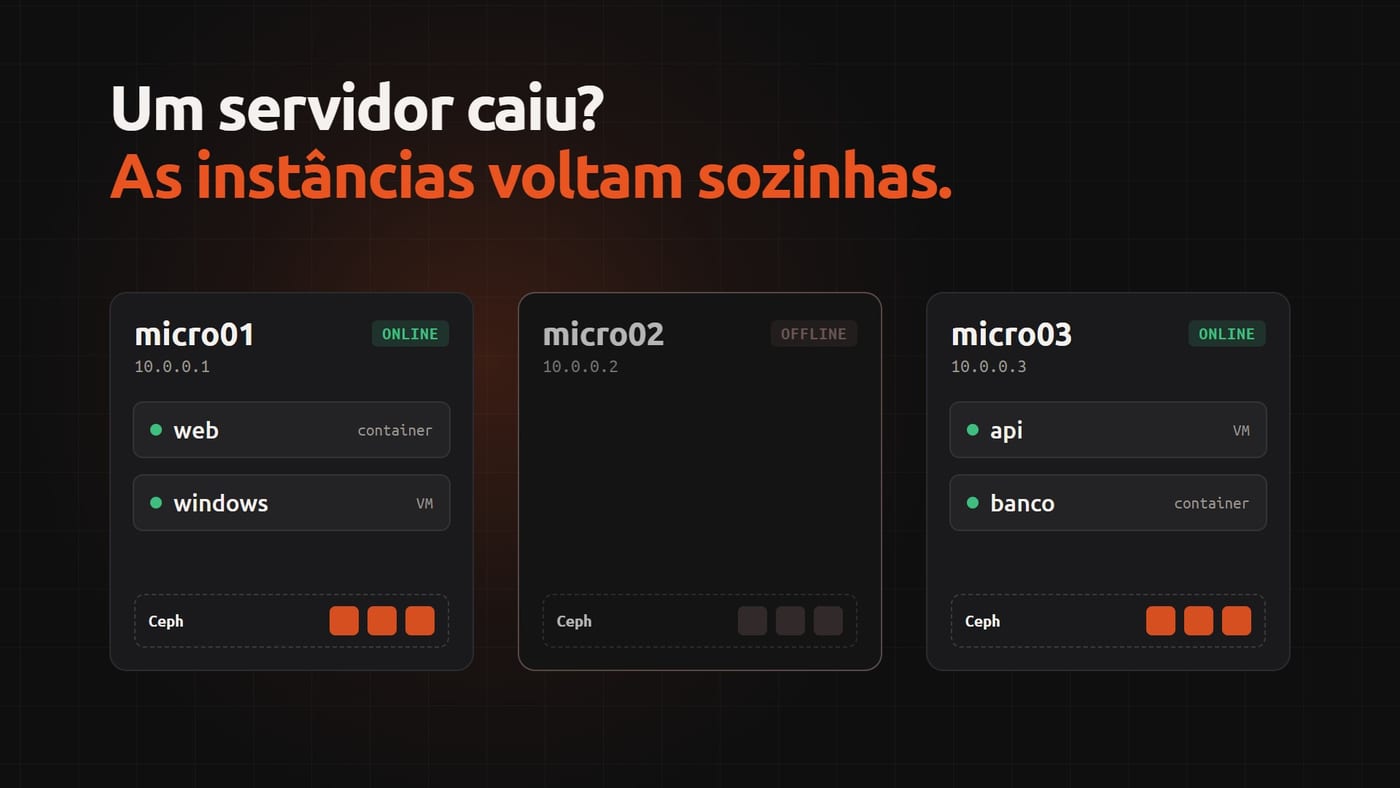
Aqui simulamos o pior caso: desligamos um servidor de forma abrupta, como numa queda de energia, com a VM Windows rodando nele. O cluster foi configurado com cluster.healing_threshold=30, o que diz ao LXD para religar as instâncias de um nó caído depois de 30 segundos fora do ar.
| Tempo | O que aconteceu |
|---|---|
| 0 s | Servidor desligado de forma abrupta |
| +21 s | Cluster marca o servidor como OFFLINE |
| +54 s | LXD evacua o servidor e transfere a VM para outro nó |
| +92 s | VM ligada no novo servidor, Windows dando boot |
| +129 s | Windows volta a responder na rede |
Pouco mais de dois minutos do desligamento até o serviço voltar, sem ninguém encostar em nada, e sem perda de dados, porque o disco da VM estava replicado no Ceph. Durante a falha, o Ceph ficou em alerta (com duas das três cópias), mas continuou lendo e gravando normalmente.
Dois pontos importantes para não criar expectativas erradas:
- Em uma falha de verdade, a VM reinicia. A memória do servidor que caiu se perdeu, então o failover é "a frio". Aplicações precisam aguentar um reboot.
- Com três servidores, o cluster tolera uma falha. Se um segundo nó cair, o Ceph perde quorum e para. Por isso a recomendação para cargas críticas é de quatro servidores ou mais.
EVACUATED e não recebe instâncias até alguém liberar com lxc cluster restore <nome>. É um comportamento proposital: evita que um servidor instável receba carga sozinho.Interface web e operação do dia a dia
Todo o cluster pode ser operado por uma interface web acessível em qualquer um dos nós, na porta 8443: criar VMs e containers, abrir o console, acompanhar o uso de CPU e memória, gerenciar redes, armazenamento e permissões. O acesso é feito com certificado TLS ou SSO, sem senha trafegando.
Para quem prefere automatizar, o mesmo controle está na linha de comando e numa API REST, e há suporte a Terraform. As instâncias rodam sobre KVM e containers de sistema, com performance próxima à de bare-metal.
distrobuilder repack-windows; sem isso, o instalador não enxerga o disco.Quando o MicroCloud faz sentido
Ele se encaixa bem quando a empresa quer nuvem privada sem a complexidade de um OpenStack:
- Pequenas e médias infraestruturas, de 3 a algumas dezenas de servidores, que precisam de alta disponibilidade;
- Filiais e edge, onde um cluster compacto e padronizado precisa rodar sem equipe local;
- Laboratórios e homologação, que precisam subir e destruir ambientes com frequência;
- Nuvem híbrida, mantendo dados sensíveis em casa e o resto na nuvem pública.
Em compensação, é um cluster: exige rede bem planejada, discos dedicados, monitoramento e alguém que acompanhe atualizações e capacidade do Ceph. Funciona melhor quando foi desenhado desde o início, e não montado com o que sobrou.
A TRIAT, parceira oficial da Canonical, projeta, implanta e monitora clusters MicroCloud. Cuidamos do dimensionamento de rede e storage, dos testes de failover, do monitoramento com Zabbix e da rotina de backup. Se você quer avaliar o MicroCloud no seu ambiente, fale com a gente.
Precisa disso rodando na sua empresa?
A TRIAT implanta e monitora Linux, storage, virtualização, redes e segurança — do projeto ao suporte 24/7.
Falar com um especialista